Documentos internos de OpenAI y Microsoft muestran que sus propios ejecutivos veían a la IA como sustituto del periodismo. El New York Times los consiguió porque el sistema judicial estadounidense obliga a mostrar las cartas. En Argentina, Editorial Perfil litiga con una ley más favorable y sin acceso a nada parecido.
El 17 de septiembre se hicieron públicas partes antes tachadas de un escrito que The New York Times y otros medios presentaron ante el juez federal Sidney Stein, en Nueva York. Ahí aparecen mensajes internos de OpenAI y Microsoft que describen sus productos de IA como reemplazo del periodismo y el entrenamiento con contenido ajeno como un robo. Hace cuatro semanas, Editorial Perfil llevó un reclamo parecido a la Justicia federal argentina. Y la pregunta argentina que nadie está haciendo es si Perfil va a poder probar algo de lo que el Times acaba de mostrar.
La respuesta es muy simple: con las herramientas actuales, muy difícilmente. No por falta de ley. Por falta de acceso a la prueba.
Lo que decían adentro
Nick Turley, jefe de ChatGPT en OpenAI, escribió internamente que los medios enfrentaban una «amenaza existencial» frente a productos que ya eran «en gran medida sustitutivos» y que lo iban a ser cada vez más a medida que mejoraran. No es una frase de un crítico externo. Es el responsable del producto describiendo lo que hace el producto.
Brent Hecht, director de ciencia aplicada de Microsoft y profesor en Northwestern University, fue más lejos. En un memo de enero de 2023 calificó el entrenamiento con obras ajenas como «un robo asombroso de proporciones sin precedentes». Un año después, en una presentación interna, describió un círculo vicioso: si los asistentes de IA le sacan tráfico a los sitios que producen contenido, terminan dañando a la vez a la web y a los propios modelos, que se quedan sin material nuevo del cual aprender. Según el escrito, el documento señalaba lo inusual de un producto que amenaza la base económica de sus propios proveedores.
Los números que sostenían esa advertencia eran de Microsoft. Las respuestas de Copilot redujeron los clics hacia el sitio del Times entre un 83% y un 93% en comparación con la búsqueda tradicional de Bing. Quien pregunta y recibe la respuesta ya armada no entra a leer la nota.
Hay más. Un empleado de OpenAI le contó al presidente de la compañía, Greg Brockman, que había encontrado un truco para saltear el muro de pago del Times y extraer su contenido. La respuesta de Brockman fue «ah nice». Y Satya Nadella, CEO de Microsoft, declaró bajo juramento que todo lo que está detrás de un muro de pago debería licenciarse para entrenar modelos, y que si hubiera sabido que OpenAI lo había hecho, habría exigido que los reentrenara.
Nada de esto es un veredicto. Es un escrito de parte, con fragmentos elegidos por los demandantes, y varios documentos de fondo siguen sellados. Microsoft sostiene que las frases de Hecht reflejan la opinión individual de un empleado y no un análisis jurídico. OpenAI defiende que entrenar con material protegido es uso legítimo. El caso está en la etapa previa al juicio, y el juez puede leer el contexto completo de otra manera.
Cómo se llegó a eso
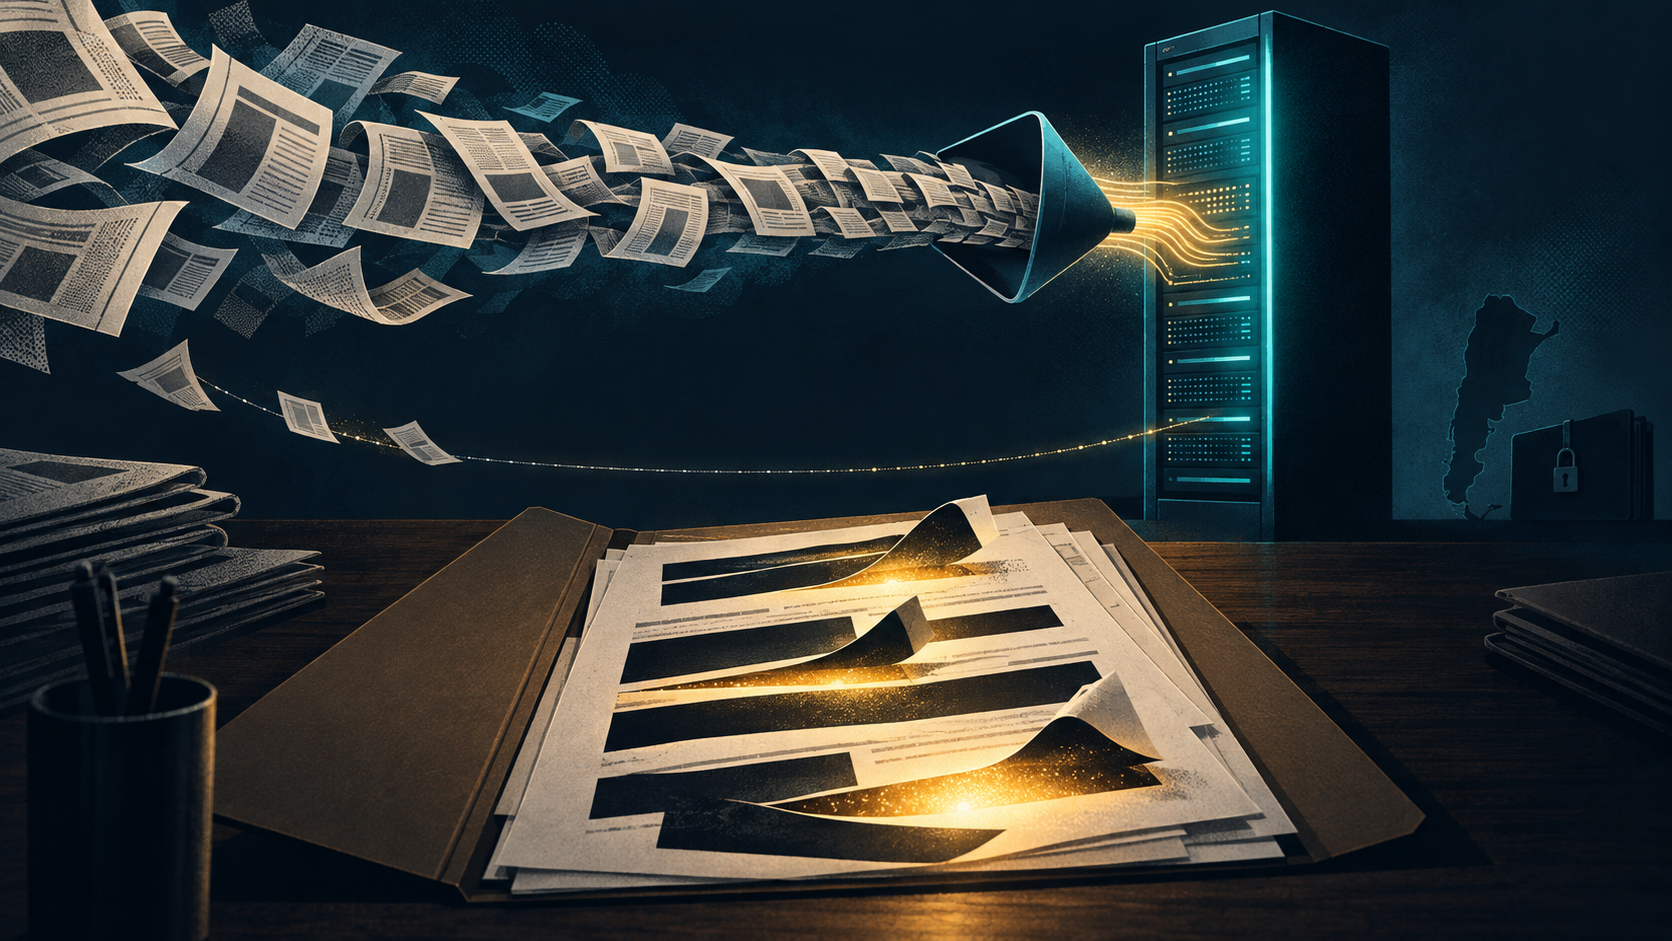
Nada de ese material habría salido a la luz sin el discovery, el mecanismo del proceso civil estadounidense que obliga a cada parte a entregar la documentación interna relevante para el caso. Correos, memos, presentaciones, planillas de tráfico, declaraciones juradas de ejecutivos. El Times no tuvo que adivinar qué pasaba adentro de OpenAI y Microsoft. Pudo pedirlo.
Y lo que consiguió apunta exactamente al punto débil de la defensa. En Estados Unidos, el uso legítimo se evalúa con varios factores, y uno central es el efecto sobre el mercado de la obra original. Si los propios ejecutivos de las empresas describieron sus productos como sustitutos del periodismo, y los datos internos muestran la caída del tráfico, la discusión sobre daño al mercado deja de ser teórica.
Y ahí es donde la conversación se vuelve concreta para Argentina. Editorial Perfil demandó por daños y perjuicios a OpenAI, a Microsoft Corporation y a Microsoft de Argentina en el fuero Civil y Comercial Federal. Es la primera vez que este conflicto llega a un tribunal argentino.
En los papeles, Perfil pisa un terreno más firme que el del Times. La Ley 11.723 no tiene una doctrina de uso legítimo como la estadounidense. Su sistema de excepciones es cerrado y no incluye la minería de textos y datos, que otros países sí contemplan. Reproducir una obra sin autorización para entrenar un modelo es, en principio, una reproducción no autorizada.
Pero la ley no alcanza si no se puede probar el hecho. Ninguna norma argentina obliga a las empresas que entrenan modelos a informar con qué datos lo hicieron. El proceso local permite pedir la exhibición de documentos concretos, pero no tiene nada con el alcance del discovery. Y los servidores, los datasets y los equipos que tomaron las decisiones están fuera del país.
El problema no es la ley. Es la prueba.
Lo que se viene
El juez Stein tiene que resolver los pedidos de fallo anticipado. Puede definir parte del caso o mandarlo a juicio. Pase lo que pase, los documentos ya circulan, y funcionan como munición en cualquier negociación entre medios y empresas de IA en el mundo. Incluida la de Perfil.
El otro camino ya tiene un antecedente regional. Folha de S.Paulo demandó a OpenAI en 2025 y en mayo de este año cerró, junto al Grupo UOL, un acuerdo de licencia con resúmenes atribuidos y enlaces a las notas originales. Demandar y licenciar no son opciones opuestas. A veces una es la antesala de la otra.
Mientras tanto, Europa discute obligar a los desarrolladores a documentar qué obras usaron para entrenar. Es decir, convertir la transparencia en regla y no en algo que cada medio tiene que arrancar en un tribunal.
Lo que muestran los documentos del Times es que las empresas sabían. Lo que muestra el caso Perfil es que saberlo no alcanza si nadie está obligado a decirlo. Entre esos dos datos se juega el valor del periodismo en la era de los asistentes: quién puede demostrar que su trabajo fue usado, y quién no.
La pregunta es si Argentina va a exigir transparencia sobre los datos de entrenamiento o va a dejar que cada medio litigue solo.
Columna de IA por Esteban Terranova